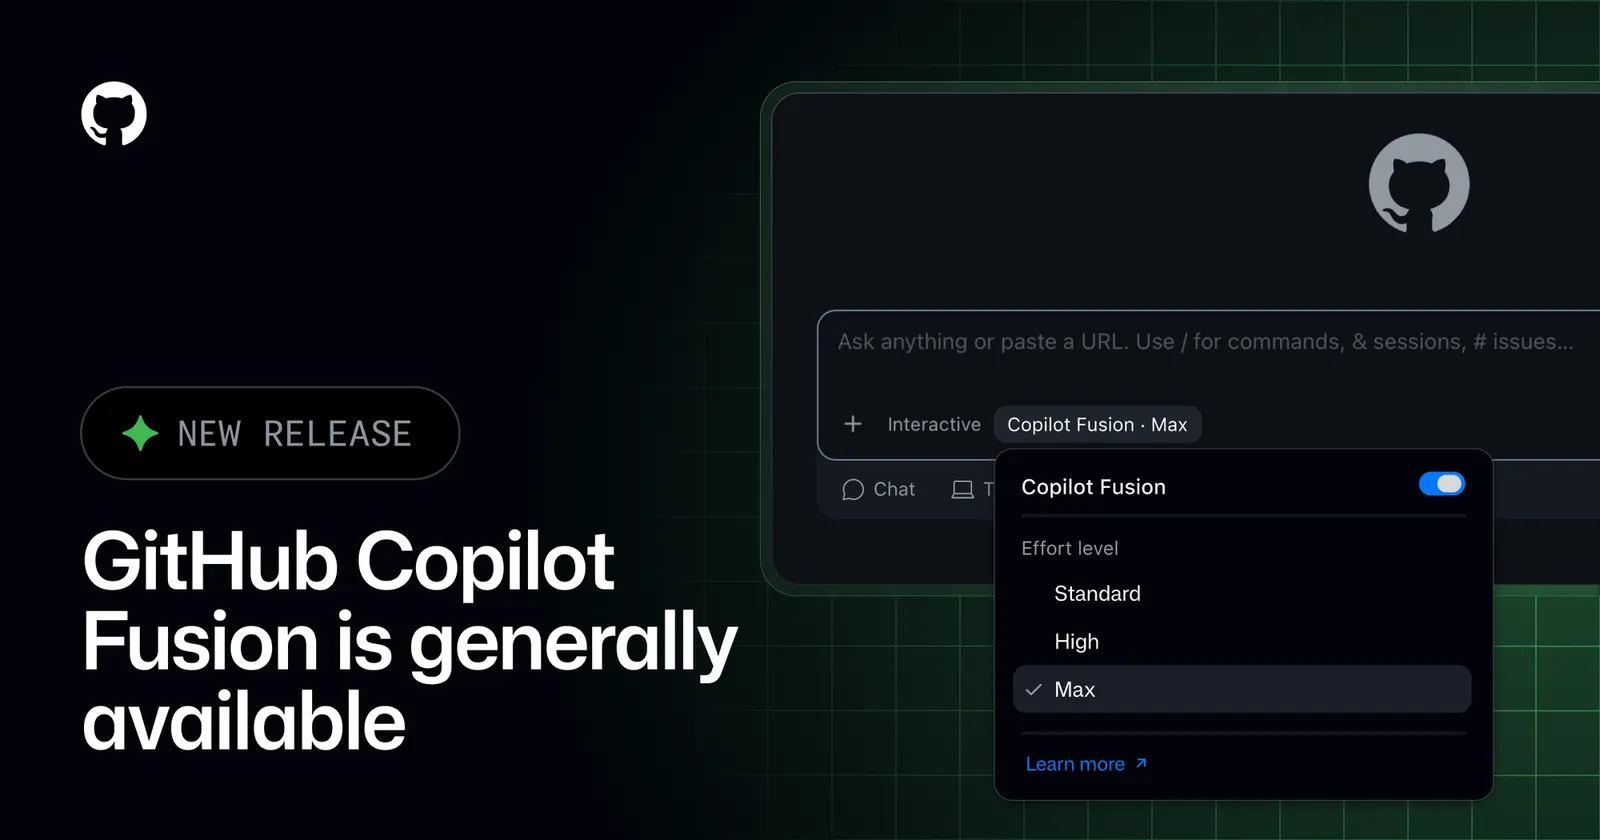
GitHub ha puesto en disponibilidad general Copilot Fusion, un modo que deja de pedirte que elijas modelo y lo decide él para cada tarea. Según el anuncio en el changelog de GitHub del 28 de octubre, su versión más potente quedó a dos puntos de Claude Code con Opus 5.5 Max en un índice independiente de agentes de programación, gastando más o menos la mitad por tarea.
Es la jugada más interesante de GitHub Universe para quien paga la factura. Lo que vende GitHub es la decisión de cuándo merece la pena pagar el modelo caro.
Puntos clave
- Qué es: un selector de modelo que no es un modelo. Eliges Copilot Fusion y un nivel de esfuerzo (Standard, High o Max), y el sistema reparte cada petición entre los modelos que tu empresa tenga activados.
- Resultado medido: en el Coding Agent Index de Artificial Analysis, Fusion Max sacó 60 puntos, a dos de Claude Code con Opus 5.5 Max. Con la mitad de coste medio de API por tarea, la mitad de tokens y un 40% menos de tiempo.
- Precio: pagas cada modelo que use a su tarifa normal. Durante un tiempo limitado, los planes de pago tienen un 30% de descuento en el coste de modelos cuando usan Fusion.
- Dónde: todos los planes de Copilot, en Visual Studio Code, la app de GitHub Copilot, Copilot CLI y los IDE de JetBrains.
Cómo decide qué modelo usar
Fusion junta dos piezas que GitHub tenía por separado. Una es Project HydraFusion, su experimento de orquestar varios modelos en una misma tarea. La otra es la selección automática de modelo que Copilot ya traía, afinada para elegir uno según la petición.
Para cada prompt, Fusion escoge uno de tres caminos. En el más simple (Single), un solo modelo resuelve la tarea. En cascada (Cascade), un modelo barato hace el borrador, un control de calidad lo revisa y, si no pasa, lo sube a un modelo más fuerte. Y en crítica (Critique), un modelo escribe, otro lo revisa y el primero corrige.
La cascada es la que explica el ahorro. La mayoría de lo que un programador pide a lo largo del día es trabajo de diario: renombrar, escribir un test, explicar una función. Eso no necesita el modelo más caro del mercado. El modelo caro solo entra cuando el barato no llega.
Los tres niveles de esfuerzo funcionan como un dial. Standard prioriza modelos versátiles para el día a día. High tira de modelos más capaces para tareas difíciles. Max va a por los más potentes cuando el problema lo pide.
El problema que resuelve es de hábitos
La cita que GitHub ha elegido para el anuncio lo cuenta mejor que cualquier benchmark. Hari Pokhrel, ingeniero principal de software en AT&T, explica que sus desarrolladores cogían un modelo potente para una tarea compleja y se olvidaban de volver al barato para lo de siempre.
Cualquiera que haya gestionado una cuenta de IA en una empresa lo ha visto. La gente deja puesto el modelo top porque nadie quiere arriesgarse a una respuesta peor, y la factura sube sin que nadie lo haya decidido. AT&T dice que Fusion Standard le ha mejorado la eficiencia en tokens en toda la compañía y que las decisiones del sistema han ido a mejor con el tiempo.
Ojo con el dato del ahorro. Es una medición de GitHub sobre un índice concreto, publicada en su propio anuncio. Que en tu código salga la mitad depende de qué mezcla de tareas tenga tu equipo. Si casi todo es refactorizar código complejo, la cascada va a escalar mucho y el ahorro será menor.
Qué controla el administrador
Esta parte es la que va a mirar el responsable de tecnología antes de activarlo. Fusion solo usa los modelos que estén permitidos en las políticas de modelos de la empresa y de la organización. Si tu empresa no ha aprobado un proveedor, Fusion no lo va a usar por la puerta de atrás.
Los administradores de Enterprise pueden ver de qué modelos tira Fusion, fijar el estado de cada uno y quitar un modelo solo para Fusion sin quitárselo al resto de usuarios. También pueden poner Fusion como modelo por defecto para toda la plantilla, en el nivel de esfuerzo que prefieran, desde los ajustes gestionados de Enterprise.
Los que estaban en la vista previa no tienen que hacer nada: si tenían activado auto, HydraFusion o HydraFusion Max, pasan solos al nivel equivalente de Fusion. Y GitHub ha publicado el mismo día que Fusion ya admite modelos locales.
Por qué llega ahora
El mercado de modelos se ha llenado de opciones a precios muy distintos en pocas semanas. OpenAI sacó GPT-6.1 Terra a mitad de precio que Sol, Google acaba de presentar Gemini 4 Carbon con una tarifa de lanzamiento de 2 dólares por millón de tokens de entrada, y OpenAI y Anthropic llevan semanas bajando precios hasta un 80%.
Con tanta oferta, elegir modelo a mano para cada tarea es un trabajo en sí. Y es un trabajo que el programador no quiere hacer. GitHub se coloca en medio y compite por saber qué modelo usar en cada momento. Es una posición cómoda para una empresa de Microsoft que vende acceso a modelos de OpenAI, Anthropic y Google a la vez.
También es una señal para Anthropic y OpenAI. Si el enrutador se lleva la decisión, el modelo de frontera deja de ser la opción por defecto y pasa a ser la opción de escalado. Se paga solo cuando hace falta.
Por qué importa
Si tu empresa paga Copilot para su equipo técnico, esto es lo más parecido a un ahorro gratis que vas a ver este trimestre. Activa Fusion Standard como predeterminado en un equipo piloto durante dos semanas, compara el gasto en modelos con las dos semanas anteriores y pregunta a los desarrolladores si han notado respuestas peores.
Si no usas Copilot, la idea te sirve igual. Muchas empresas usan un único modelo para todo, el más caro, porque nadie se ha sentado a decidir otra cosa. Y en español la factura pesa más: ya contamos que la IA gasta hasta un 51% más de tokens en español. Separar lo rutinario de lo difícil y mandar cada cosa a su modelo es una decisión de operaciones, y se puede tomar mañana.
Fuente original: github.blog
Relacionado