Databricks ha presentado MemCurrent, una arquitectura de memoria para agentes que en su prueba interna con tareas reales de empresa sube la tasa de acierto del 22,3% al 68,4% sin cambiar de modelo. Lo publicó su equipo de investigación el 20 de octubre, y ya funciona dentro de Genie, su asistente para consultar datos en lenguaje natural, y en Agent Bricks Memory, en beta, para agentes propios.
El agente, además, gasta un 31% menos de tokens y va un 26% más rápido. Lo habitual es que mejorar la calidad de un agente cueste dinero o latencia, y aquí bajan las dos cosas a la vez.
Puntos clave
- Acierto del 22,3% al 68,4% en 114 casos de prueba construidos con 2.233 sesiones reales de 29 usuarios de Genie.
- 12 veces menos tokens: en tres benchmarks públicos (LoCoMo, LongMemEval y ConvoMem) iguala a meter toda la conversación en contexto, 88,1% frente a 87,8%, con 8.400 tokens por pregunta en vez de 103.000.
- Por delante de Mem0, PropMem y la memoria de OpenClaw, tres sistemas abiertos. Mem0 se queda en el 43,9% en la prueba interna.
- Disponible ya en Genie y en Agent Bricks Memory (beta), sobre Lakebase, la base de datos Postgres de Databricks.
Cómo funciona la memoria de MemCurrent
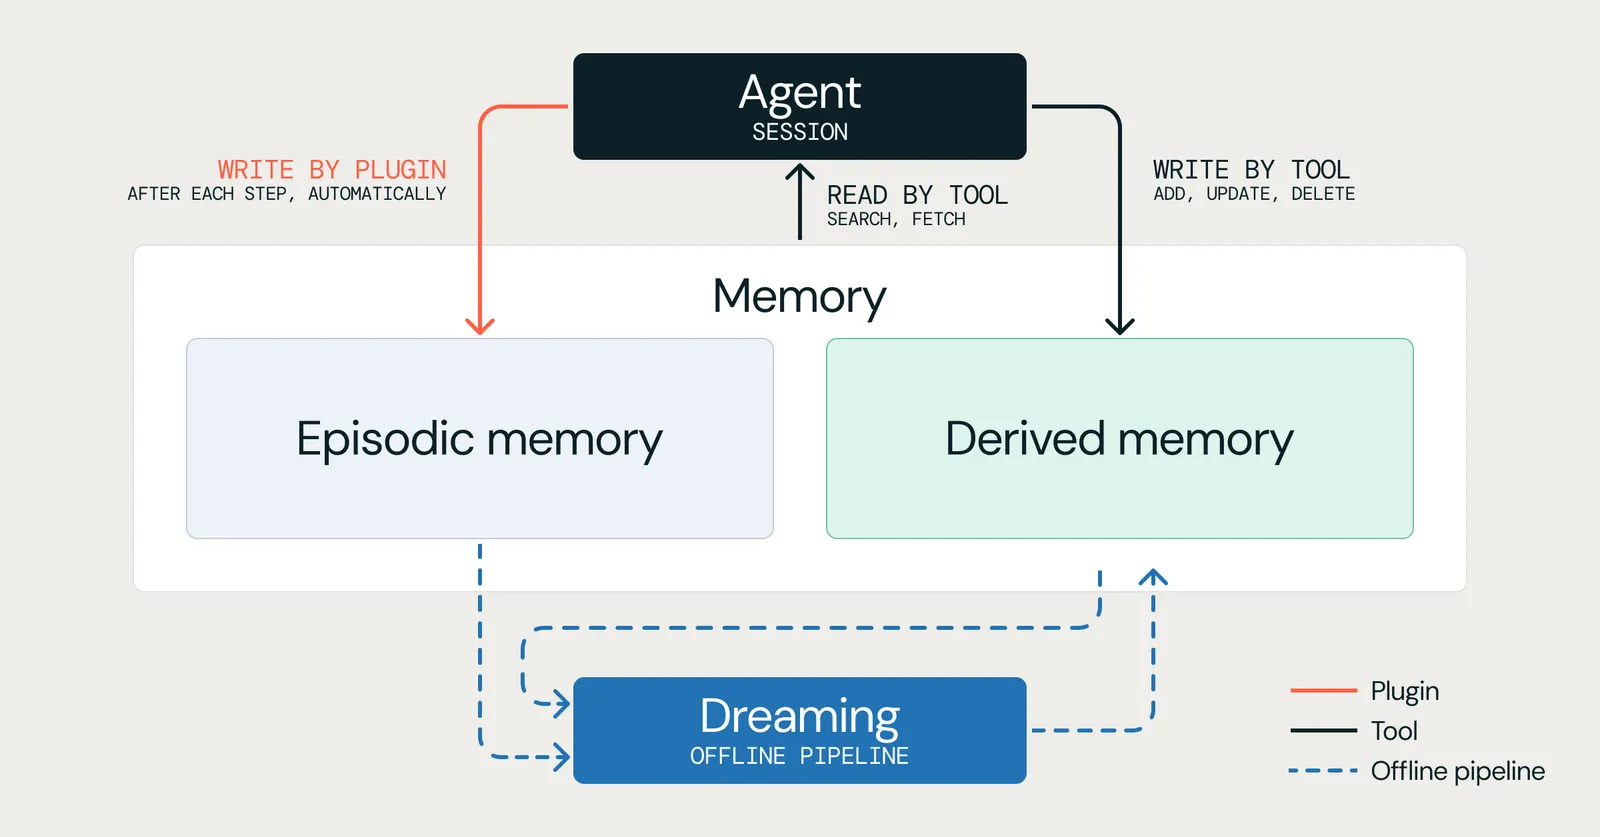
Databricks separa dos tipos de memoria. La episódica guarda las sesiones tal cual, paso a paso, y solo crece: nunca se reescribe. La derivada guarda lo aprendido, como preferencias del usuario, correcciones, definiciones de métricas o flujos de trabajo que funcionaron. Va en ficheros dentro de una base de conocimiento, con un índice, memory.md, que se genera solo.
Y combina tres formas de leer y escribir. Un plugin registra cada paso y, al empezar la sesión, le inyecta al agente el índice, así sabe lo que sabe antes de arrancar. El agente tiene herramientas para añadir, actualizar, borrar, buscar y recuperar memorias cuando el usuario se lo pide de forma explícita ("nunca escribas scripts en /tmp"). Y un proceso en segundo plano, que Databricks llama *dreaming*, repasa las sesiones nuevas, saca lo aprendido aunque nadie lo haya dicho, fusiona duplicados, parte los ficheros que han crecido demasiado y resuelve contradicciones.
Las pruebas pieza por pieza dicen dónde está el valor. Solo con memoria episódica el acierto sube al 35,8%: el agente busca en el historial en un tercio de los casos y, cuando lo hace, acierta el 60%. Con la memoria derivada sube al 66,1%, porque el índice le dice qué hay guardado y cuándo mirar. Las dos juntas llegan al 68,4%. Y el proceso de *dreaming* por sí solo (63,5%) gana por casi diez puntos a las herramientas solas (53,9%).
Dos ejemplos de Genie
El primero es una alucinación. Un usuario pidió los 20 usuarios más activos de un producto en los dos últimos meses. El agente escribió bien la consulta SQL, pero no leyó el resultado y se inventó la tabla. El usuario lo corrigió, el agente guardó la lección y la siguiente vez leyó los resultados antes de contestar. Una corrección evitó que un despiste se convirtiera en costumbre.
El segundo es ahorro puro. Para sacar los 5 principales clientes de SDP, el agente tuvo que averiguar qué significaba SDP, qué tablas tenían los datos de uso y cómo cruzarlas: 11 llamadas a herramientas, 8 subagentes y casi seis minutos. Guardó el camino como flujo de trabajo. Cuando más tarde le preguntaron cuántos clientes de SDP habían pasado de 5.000 ejecuciones el mes anterior, contestó en 41 segundos con 2 llamadas y un subagente.
Lo que conviene matizar
La cifra estrella sale de un benchmark que Databricks ha construido con datos de su propio producto, y eso pide cautela. Son 114 casos, puntuados por otro modelo que hace de juez, con una revisión manual al final. En los benchmarks públicos la ventaja sobre la competencia es bastante más corta.
Los modelos también cuentan. En la prueba interna el agente era Claude Opus 4.6 y la memoria la gestionaba GPT 5.6 sol. Con otra combinación los números pueden moverse.
Y, como recuerda The Deep View, MemCurrent es una arquitectura que vive dentro de los productos de Databricks. Si no trabajas sobre su plataforma, lo que te llevas es el diseño, que el artículo explica con bastante detalle.
Databricks no es el único que va por aquí. En agosto contamos cómo Engram y Harvey bajaron una consulta legal de 1,32 a 0,13 dólares dándole memoria al agente, y Anthropic ya comparte memoria entre el chat de Claude y Cowork. Michael Bendersky, director de investigación en IA de Databricks, lo resumía a The Deep View con la idea de no tener que volver a explicarle lo mismo al agente en el siguiente proyecto.
Por qué importa
Casi todas las empresas que montan agentes discuten ahora mismo qué modelo usar. Este trabajo apunta a que buena parte de la mejora está en lo que el agente recuerda de tu empresa: qué tabla es la buena, qué significa cada sigla interna, qué le corrigió el equipo la semana pasada.
En Digital Brain y en Barner trabajamos así con Claude Code: un CLAUDE.md con las reglas y los errores pasados que el agente lee al empezar cada sesión. MemCurrent automatiza eso, incluida la parte más pesada, que es limpiar y consolidar lo que se va acumulando.
Si vas a desplegar agentes, mide primero cuántas veces tus usuarios les explican lo mismo. Ese número es, más o menos, lo que te puede ahorrar la memoria.
Fuente original: databricks.com
Relacionado