Qwen3.8-27B corre en Cerebras a unos 1.500 tokens por segundo
Cerebras ha metido Qwen3.8-27B en sus endpoints públicos a unos 1.500 tokens por segundo. Su catálogo de modelos lista el modelo como qwen-3.8-27b, con 27.
 Newsletter
Tag
La inferencia, el coste oculto de la IA: servir modelos a escala, chips especializados y la economía de cada respuesta.
Cerebras ha metido Qwen3.8-27B en sus endpoints públicos a unos 1.500 tokens por segundo. Su catálogo de modelos lista el modelo como qwen-3.8-27b, con 27.
Nvidia ha publicado PAIR, un router de IA personal gratuito y de código abierto que encuentra los ordenadores compatibles de tu red local y reparte entre…

Perplexity ha lanzado Portable Computer, una versión de su agente que corre entera dentro del ordenador del usuario y no consume créditos de facturación…
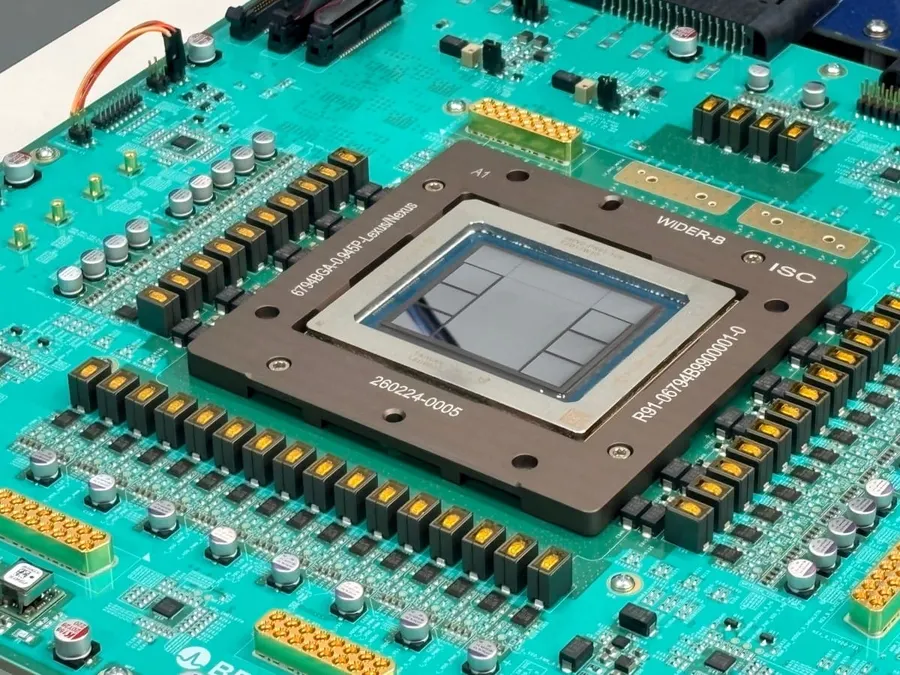
OpenAI ha publicado los primeros números de Jalapeño, el chip de inferencia que lleva desarrollando con Broadcom desde octubre de 2025, y los ha pasado…
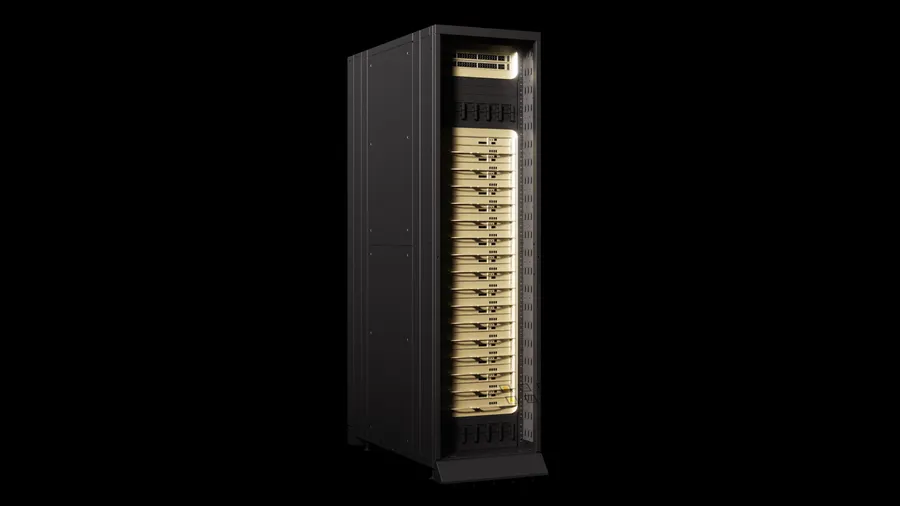
Nvidia ha puesto Groq 3 LPX en producción plena, el acelerador de inferencia con el que quiere quedarse la parte del negocio de IA que ahora mismo crece…
Nvidia dice que Vera Rubin NVL72 rinde hasta 30 veces más por megavatio que GB300 NVL72, su generación anterior, y que el coste por token en cargas de…
Callosum ha levantado 100 millones de dólares en una ronda semilla liderada por Atomico para orquestar peticiones de IA entre chips distintos. La…

Liquid AI ha publicado DSpark, una técnica de decodificación especulativa que acelera hasta 3,18 veces la inferencia de sus modelos LFM2.5 sin cambiar la…
Etched ha levantado 700 millones de dólares a una valoración de 21.000 millones, el doble de lo que valía hace un mes. La ronda la lidera Jane Street, el…
Groq ha levantado 350 millones de dólares a una valoración de 3.500 millones, según TechCrunch. En septiembre de 2025 valía 6.900. La empresa que se hizo…

La startup francesa Kog dice haber sacado 3.000 tokens de salida por segundo en una sola petición sobre un nodo de ocho AMD MI300X. Sin decodificación…

Google ha publicado en abierto TPU Raiden, la biblioteca que mueve la caché de atención entre sus chips durante la inferencia. Va con licencia Apache 2.0…

AMD ha comprado Taalas, una startup de Toronto que fabrica chips de inferencia con una idea poco ortodoxa: en lugar de cargar los pesos del modelo desde…

Etched, la startup de chips de IA fundada por tres ex alumnos de Harvard, dobla su valoración hasta los 10.300 millones de dólares con una apuesta que…

Fireworks ha levantado 1.505 millones de dólares a una valoración de 17.500 millones, según [el anuncio publicado por la propia…

SambaNova, fabricante de chips de inferencia de IA, ha captado 1.000 millones de dólares en el primer cierre de una ronda Serie F que la valora en 11.000…

DeepSeek, el laboratorio chino que sacudió el sector con su modelo R1, está diseñando su propio chip de inferencia para depender menos de Nvidia y…

Hugging Face y Cerebras han montado un asistente de voz que responde en tiempo real, y el truco no está en el micrófono ni en el altavoz. Está en el…

OpenAI ya no quiere depender solo de Nvidia para mover sus modelos. El 24 de junio, junto a Broadcom, presentó Jalapeño, su primer chip propio. No es…

Etched acaba de salir del sigilo con un ataque directo al punto mas caro de la IA: la inferencia, es decir, el coste de que un modelo responda millones…

Google DeepMind ha publicado DiffusionGemma, un modelo open source experimental que cambia cómo se genera texto. En lugar de predecir un token detrás de…